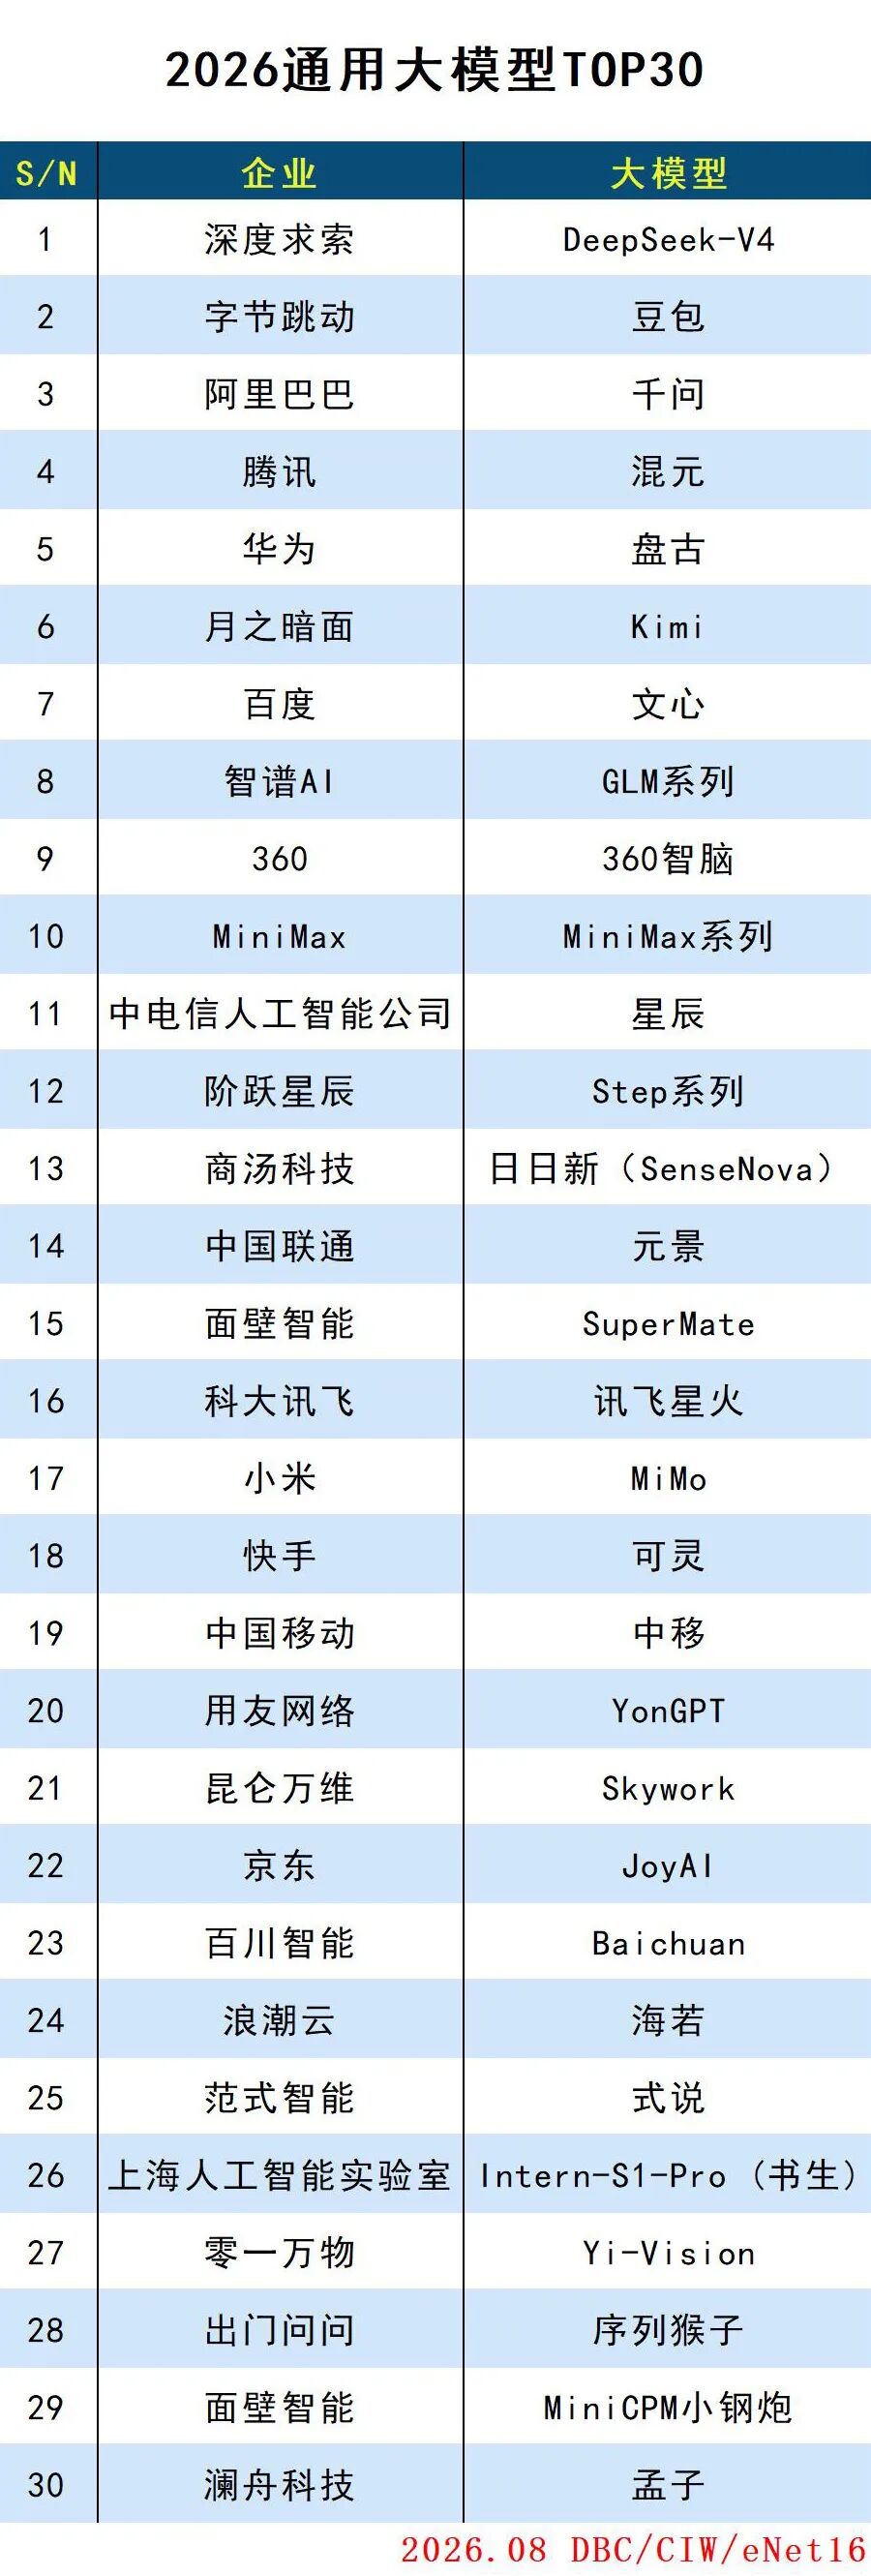
2026通用大模型TOP30
从技术本质上看,通用大模型的核心在于“预训练”与“微调”的成熟,其基础架构通常基于深度神经网络中的变换器结构,通过在海量、多源、异构的互联网数据上进行自监督学习,模型得以捕捉人类语言与知识体系中的深层统计规律。这一过程相当于让模型完成了一场“通识教育”——它阅读了相当于人类数千年阅读量的文本,学习了语法、逻辑、常识乃至某种程度的“世界知识”。此后,只需通过相对少量的特定领域数据对模型进行引导性微调,它便能快速适应问答、创作、推理、编程等迥异的下游任务。
从更宏观的产业生态视角观察,通用大模型的研发已演变为一场对算力、数据和人才的综合性考验。